Google, EmbeddingGemma 2’yi duyurdu. Cihaz üzerinde çoklu veri türleriyle arama olanağı sunan modelin hukuk büroları için potansiyeli ve veri mahremiyeti sınırları.
Kısa cevap: EmbeddingGemma 2
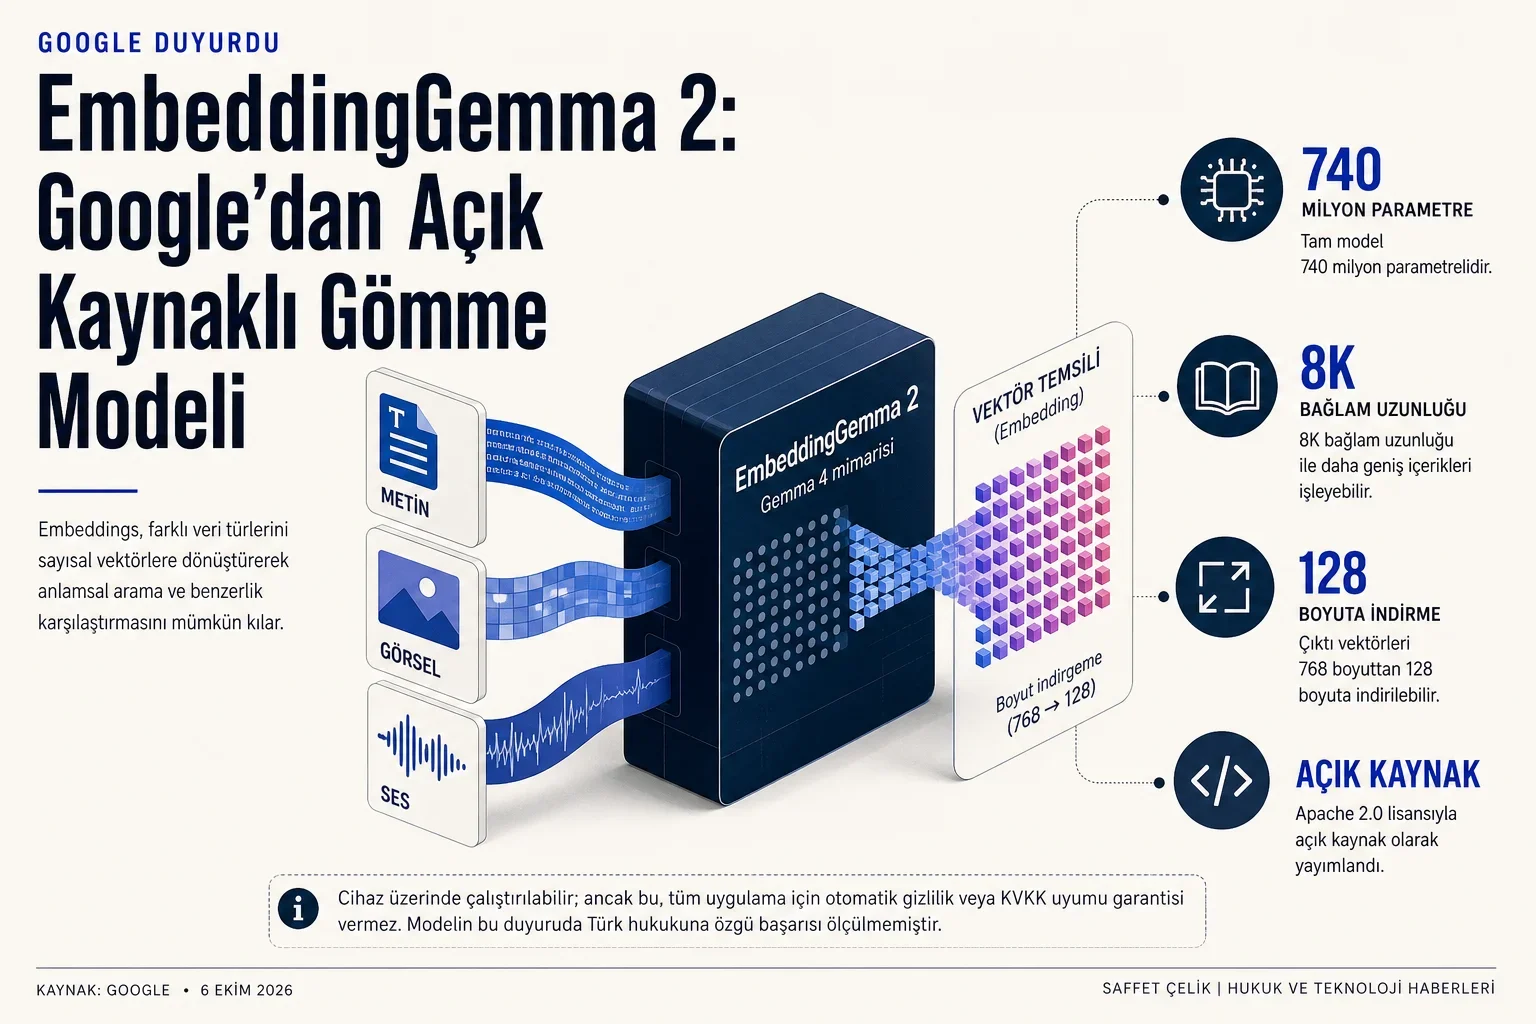
EmbeddingGemma 2, Google’ın 6 Ekim 2026’da duyurduğu; metin, kod, görüntü, video ve sesi ortak sayısal temsillere dönüştüren açık kaynaklı bir gömme modelidir. Bu temsiller anlamsal aramada kullanılabilir. Model cihaz üzerinde çalıştırılabilir; uygulamanın bütünüyle çevrim dışı kalması ise arama, depolama ve diğer model bağlantılarının nasıl kurulduğuna bağlıdır. Tek başına model seçimi veri güvenliği veya KVKK uyumu garantisi sağlamaz.
EmbeddingGemma 2 Nedir ve Önceki Sürümlerden Farkı Ne?
Teknoloji devi Google, yapay zeka alanındaki açık kaynak model ailesini genişletmeye devam ediyor. 6 Ekim 2026 tarihli bir duyuruyla, EmbeddingGemma 2 modelini geliştirici topluluğunun kullanımına sundu. Gemma 4 mimarisi üzerine inşa edilen bu yeni model, bir önceki sürüm olan ve yalnızca metin verileri üzerinde çalışan EmbeddingGemma'nın yeteneklerini çok daha ileri bir seviyeye taşıyor.
En temel farkı, çoklu modal (multimodal) yapısıdır. Bu, modelin sadece metinleri değil, aynı zamanda kod parçacıklarını, görselleri, kısa videoları ve ses kayıtlarını da anlayıp birbiriyle ilişkilendirebilmesi anlamına gelir. Örneğin, bir sesli nottaki konuşmadan yola çıkarak ilgili video klibini bulabilir veya bir resimle anlamsal olarak benzer metinleri arayabilir. Tüm bunları tek ve entegre bir modelle gerçekleştirir.
740 milyon parametreye sahip olan model, bu yeteneklerine rağmen oldukça hafif ve verimli çalışacak şekilde tasarlanmıştır. Bu sayede, güçlü bulut sunucularına ihtiyaç duymadan, modern akıllı telefonlar veya dizüstü bilgisayarlar gibi son kullanıcı cihazlarında etkin bir şekilde çalışabilir. Apache 2.0 gibi ticari kullanıma izin veren bir lisansla yayımlanması da modelin geniş bir kitle tarafından benimsenmesini teşvik etmektedir.
Modelin Teknik Özellikleri ve Performans Metrikleri
Google, EmbeddingGemma 2’nin kendi boyut sınıfında güçlü karşılaştırma sonuçları verdiğini bildiriyor. Bunlar üreticinin yayımladığı testlerdir; bir hukuk bürosunun dosyalarındaki doğruluk ve cihaz performansı ayrıca ölçülmelidir. Aşağıdaki değerler Google’ın duyurusundaki yapılandırmalara aittir.
Aşağıdaki tablo, EmbeddingGemma 2'nin temel teknik özelliklerini özetlemektedir:
| Özellik | Açıklama |
|---|---|
| Parametre Sayısı | Modüler yapıdadır. Sadece metin için 270M, tam çoklu modal destek için toplamda ~740M parametreye sahiptir. |
| Bağlam Penceresi (Context Window) | 8.192 token. Bu, bir önceki modelden 4 kat daha büyüktür ve daha uzun metin, ses veya daha fazla görseli tek seferde işlemesine olanak tanır. |
| Veri Türleri | Metin, kod, resim, video ve ses. Bu verileri ortak bir gömme (embedding) uzayında birleştirir. |
| Depolama Verimliliği | Matryoshka Temsil Öğrenimi (MRL) sayesinde çıktı vektörleri 768 boyuttan 128'e kadar dinamik olarak küçültülebilir, bu da 6 kata kadar depolama tasarrufu sağlar. |
| Cihaz Üzeri Performans | Google Pixel 11 Pro gibi bir cihazda, nicemleme (quantization) ile metin için ~191 MB, tam model için ~567 MB RAM gerektirir. |
| Lisans | Apache 2.0. Ticari kullanıma uygun, serbest bir lisansla sunulmuştur. |
Google’ın yayımladığı MTEB Code sonucunda puan 68,76’dan 78,68’e yükseliyor: artış 9,92 puandır. Bu değer yüzde 9,92 iyileşme anlamına gelmez. Sonuç kod araması için bir gösterge sunar; Türkçe hukuki belge aramasında aynı başarının elde edildiğini kanıtlamaz.
Editoryal Değerlendirme: Türkiye'deki Hukukçular ve Kurumlar İçin Ne Anlama Geliyor?
EmbeddingGemma 2 gibi cihaz üzerinde çalışan güçlü yapay zeka modellerinin ortaya çıkışı, sadece teknoloji dünyası için değil, aynı zamanda hukuk gibi verinin son derece hassas olduğu sektörler için de önemli sonuçlar doğurmaktadır. Türkiye özelinde bu teknolojinin potansiyel etkilerini ve hukuki boyutunu değerlendirmek gerekir.
Yerel İşlemenin Veri Mahremiyeti Açısından Anlamı
Bulut tabanlı bir hizmet kullanıldığında veri, hizmetin mimarisine göre dış sunuculara aktarılabilir. 6698 sayılı Kişisel Verilerin Korunması Kanunu m. 4’teki genel ilkeler ve yurt dışına aktarım varsa m. 9’daki koşullar ayrıca değerlendirilir. Gömme hesabını yerelde yapmak veri aktarımını azaltma olanağı sunar. Ancak telemetri, bulut yedekleme, uzak vektör deposu veya başka bir üretken modele gönderim varsa veriler yine cihaz dışına çıkabilir. Bu nedenle yerel çalışma, kendiliğinden hukuka uygunluk ya da sızıntı olmayacağı anlamına gelmez.
Hukuk Büroları İçin Potansiyel Kullanım Alanları
Hukuk büroları ve departmanları, bu teknolojiyi kendi iç süreçlerini iyileştirmek için kullanabilir. Potansiyel uygulama alanları şunları içerir:
- Akıllı Belge Arama: Binlerce dava dosyası, dilekçe, sözleşme ve içtihat arasında anahtar kelime aramasının ötesine geçerek, anlamsal ve bağlamsal arama yapma imkanı. Örneğin, "kira uyarlama davasında hakkaniyet indirimi" sorgusuyla ilgili tüm metin, ses kaydı ve hatta sunumları bulabilir.
- Dahili Bilgi Yönetimi: Eğitim videoları, toplantı ses kayıtları veya uzman görüşleri gibi farklı formatlardaki verileri tek bir arayüzden sorgulanabilir hale getirmek.
- Yerel RAG Sistemleri: Belge aramasını bir üretken modelle birleştiren kurum içi asistanlar tasarlanabilir. Verinin yerelde kalması hedefleniyorsa hem arama hem yanıt üretimi, depolama, erişim kontrolü ve günlükleme birlikte incelenmelidir. Gömme modeli tek başına soru-cevap asistanı değildir ve bilgi sızıntısını önleme garantisi vermez.
Geliştiriciler EmbeddingGemma 2'yi Nasıl Kullanmaya Başlayabilir?
Google, geliştiricilerin modeli hızla benimseyip uygulamalarına entegre edebilmesi için geniş bir ekosistem desteği sunmaktadır. Modeli kullanmaya başlamak için izlenebilecek temel adımlar şunlardır:
- Model Ağırlıklarını İndirme: Model dosyaları, geliştiricilerin sıkça kullandığı platformlar olan Hugging Face ve Kaggle üzerinden erişime açılmıştır. Bu platformlardan modelin farklı versiyonları indirilebilir.
- Cihaz Üzeri Dağıtım Araçlarını Kullanma: Google AI Edge MediaPipe veya LiteRT gibi kütüphaneler, modeli Android ve iOS gibi platformlarda çalıştırmak için hazır çözümler sunar. Bu araçlar, karmaşık kurulum süreçlerini basitleştirir.
- Popüler Geliştirme Araçlarıyla Entegrasyon: Model; `transformers`, `sentence-transformers`, `vLLM`, `Ollama` ve `LMStudio` gibi Python tabanlı popüler yapay zeka kütüphaneleriyle uyumlu çalışır.
- Vektör Veritabanları ile Kullanım: Modelin ürettiği sayısal vektörleri (embeddings) verimli bir şekilde saklamak ve aramak için Qdrant gibi vektör veritabanları ile entegre edilebilir.
- İnce Ayar (Fine-tuning): Unsloth gibi araçlar, geliştiricilerin modeli kendi özel veri setleriyle eğiterek belirli görevler için performansını daha da artırmalarına (ince ayar yapmalarına) olanak tanır.
Potansiyel Riskler ve Dikkat Edilmesi Gerekenler
EmbeddingGemma 2 heyecan verici olanaklar sunsa da, her yapay zeka modelinde olduğu gibi dikkatli bir yaklaşımla ele alınması gereken bazı riskler ve sınırlamalar mevcuttur. Bu teknolojiyi kullanırken göz önünde bulundurulması gerekenler şunlardır:
- Modelin Performans Sınırları: EmbeddingGemma 2 bir gömme modelidir; temel işi arama ve eşleştirme için sayısal temsiller üretmektir. Hukuki muhakeme yapan veya doğrudan görüş yazan bir model gibi değerlendirilmemelidir. Arama sonuçlarının ilgili Türkçe belge kümesindeki isabeti ve eksik bıraktığı önemli belgeler ayrıca ölçülmelidir.
- Veri Kalitesi ve Yanlılık (Bias): Modelin performansı, eğitildiği verinin kalitesine doğrudan bağlıdır. Eğitim verisindeki mevcut toplumsal önyargılar, modelin çıktılarında da kendini gösterebilir ve bu durum, adil olmayan veya hatalı sonuçlara yol açabilir.
- Uygulama Katmanı Güvenliği: Modelin kendisi verileri dışarı göndermese de, onu kullanan uygulamanın kötü tasarlanması halinde güvenlik açıkları oluşabilir. Örneğin, uygulama modelin sonuçlarını analiz için kendi sunucusuna gönderebilir. Bu nedenle, sadece modele değil, onu çevreleyen yazılıma da güvenmek gerekir.
- Hukuki ve Mesleki Sorumluluk: Arama veya asistan çıktısı, dosya ve kaynak incelemesinin yerine geçmez. Hatalı sonucun sorumluluğu somut olay, ilgili yükümlülükler ve sözleşmeler çerçevesinde değerlendirilir; bütün zararın koşulsuz olarak tek bir tarafa ait olduğu söylenemez. Üretilen sonuçlar kullanılmadan önce kontrol edilmelidir. İlgili yapay zekâ ve hukuk teknolojileri yazıları da incelenebilir.
Sıkça Sorulan Sorular
EmbeddingGemma 2'yi kullanmak ücretli mi?
Hayır, EmbeddingGemma 2, ticari kullanıma da izin veren Apache 2.0 lisansı altında yayımlanmıştır. Bu, geliştiricilerin modeli indirip kendi ürünlerinde ve hizmetlerinde ücretsiz olarak kullanabileceği anlamına gelir.
Model hangi veri türlerini destekliyor?
Model çoklu modal (multimodal) bir yapıya sahiptir. Metin, bilgisayar kodu, resim, video ve ses gibi beş farklı temel veri türünü işleyebilir ve bunlar arasında anlamsal bağlantılar kurabilir.
Model Türkçe dilini ne kadar iyi destekliyor?
Google duyurusu çok dilli metin performansından söz ediyor; Türkçe hukuk metinlerine özel bir ölçüm vermiyor. Bu nedenle Türkçe dava dosyalarında yüksek doğruluk varsayılamaz. Kullanılacak belge türleri ve gerçek arama sorularıyla bir değerlendirme kümesi hazırlamak, sonuçları karşılaştırmak gerekir.
"Cihaz üzerinde çalışmak" KVKK için neden önemlidir?
Cihaz üzerinde hesaplama, bu işlem için verinin uzak bir sunucuya gönderilmesini gerektirmeyebilir. Bunun veri mahremiyetine katkısı, uygulamanın tüm veri akışına bağlıdır. Yurt dışına aktarım bulunuyorsa KVKK m. 9 ayrıca değerlendirilir; yerel hesaplama diğer veri işleme yükümlülüklerini kaldırmaz. Hukuki süreç uygulamalarında da modelin yanı sıra uygulama, depolama ve bağlantılar birlikte incelenmelidir.
Kaynak ve yayın bilgisi
EmbeddingGemma 2: an open, lightweight multimodal embedding model